
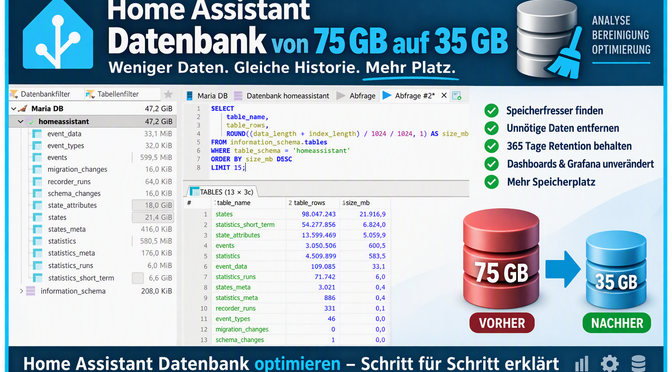
Irgendwann fällt es auf: Das Backup wird immer größer, die Historie im Dashboard lädt zäh, und auf dem Datenbank-Server geht langsam der Platz aus. Bei mir war es so weit, als die MariaDB als meine Home Assistant Datenbank auf rund 75 GB angewachsen war. Dabei wollte ich nie so viel speichern – ich habe einfach nie bewusst entschieden, was Home Assistant eigentlich aufzeichnen soll.
In diesem Beitrag zeige ich dir, wie ich die Recorder-Datenbank von rund 75 GB auf etwa 35 GB verkleinert habe, ohne die Historie zu verlieren, die ich wirklich brauche. Ich erzähle dir, wo die Daten herkamen, welche Fehler unterwegs aufgetreten sind (und es waren einige), und wie die Konfiguration am Ende aussieht. Nicht jedes SQL-Statement steht im Text – dafür die Logik dahinter, damit du es auf dein System übertragen kannst. Die wichtigsten Abfragen findest du gesammelt im Anhang am Ende.
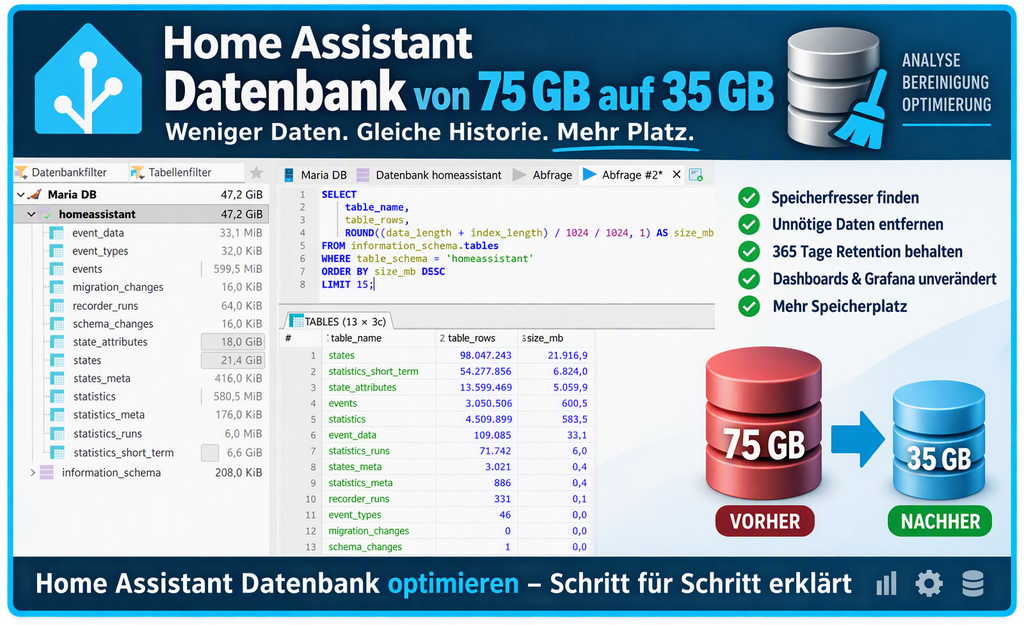
📷 Datenbankgröße vorher/nachher
🔧 Ausgangslage
Mein Setup: Home Assistant mit einer MariaDB als Recorder-Datenbank (in einem eigenen LXC-Container auf Proxmox), Grafana für Auswertungen und purge_keep_days: 365. Ein Jahr Historie wollte ich behalten – das war die Vorgabe. Es ging also nicht darum, die Aufbewahrung zu kürzen, sondern darum, nichts mehr aufzuzeichnen, was ich nie ansehe.
Der Blick in die Datenbank war ernüchternd:
| Tabelle | Größe | Zeilen |
|---|---|---|
states | ~50 GB | ~204 Mio. |
state_attributes | ~18 GB | ~52 Mio. |
statistics_short_term | ~6 GB | ~51 Mio. |
| Rest | < 2 GB | – |
👉 Fast die gesamte Last steckt in zwei Tabellen: states (jede einzelne Zustandsänderung) und state_attributes (die Attribute dazu).
🎯 Die Ziele
- ✅ 365 Tage Retention behalten
- ✅ Nur aufzeichnen, was ich auch auswerte (Dashboard-Verlauf, Grafana,
history_stats) - ✅ Alte, unnötige Daten aus der Datenbank entfernen – nicht nur künftige verhindern
- ✅ Den Platz auch wirklich zurückholen (dazu später mehr – das ist nicht selbstverständlich)
- ❌ Keine Langzeitstatistiken zerstören, die ich noch brauche
🔍 Schritt 1: Herausfinden, wo die Daten herkommen
Bevor man irgendetwas ausschließt, sollte man wissen, was eigentlich Platz frisst. Ich habe die Datenbank direkt abgefragt:
- die Top 20 Entities nach Zeilenanzahl in
states - die Auswertung nach Domain (
sensor,device_tracker,switch…) - ob für die größten Entities Langzeitstatistiken (LTS) existieren
Das Ergebnis war aufschlussreich:
- 🧮 Diagnose-Zähler wie
system_uptimeodersystem_rx_received– Millionen Zeilen ohne jeden Nutzwert - 📡 SMA-Wechselrichter: Spannung, Strom und Leistung je Phase und je String, im Sekundentakt. Sieht nach Daten aus, braucht aber niemand.
- 📱 device_tracker: allein 37 Millionen Zeilen, rund 18 % der gesamten Tabelle. Die FRITZ!Box-Integration schreibt bei jedem Scan jedes bekannte Netzwerkgerät neu.
- 🧩 Kleinvieh: Radar-Rohwerte von Präsenzsensoren, Handy-Diagnosewerte, Energie-Manager-Rechenwerte
💡 Tipp: Erst die Domain-Auswertung, dann die Einzelsensoren. Eine ganze Domain wie device_tracker oder update auszuschließen bringt oft mehr als dutzende Einzelentities.
⚠️ Die wichtigste Regel: Exclude stoppt auch die Statistik
Bevor du etwas ausschließt, musst du eines wissen:
recorder.exclude stoppt nicht nur die Rohdaten (states), sondern auch die Langzeitstatistik (statistics) dieser Entity.
Für einen Sensor, den du nur als Live-Kachel anzeigst, ist das egal. Für einen Sensor, dessen Verlauf du über Monate ansehen willst, ist es ein Fehler. Deshalb habe ich jede Entity gegen vier Fragen geprüft:
- Gibt es im Dashboard einen Verlaufsgraphen (nicht nur eine Live-Kachel)?
- Wird sie in Grafana abgefragt?
- Ist sie Quelle eines history_stats– oder statistics-Sensors?
- Hat sie Langzeitstatistiken, die ich behalten will?
Nur wenn alle vier Antworten „nein“ lauten, wandert die Entity in die Exclude-Liste. Bei mir blieben deshalb zum Beispiel Taupunkt-Werte (Verlaufsgraph), der COP der Wärmepumpe (Quelle eines Statistik-Sensors) und die geglätteten Energie-Manager-Werte bewusst aufgezeichnet.
Und noch eine Falle: Schalter und Binary-Sensoren habe ich nicht als Domain ausgeschlossen, obwohl sie viele Zeilen erzeugen. Laufzeitauswertungen wie „Jacuzzi-Heizung heute“ oder Waschmaschinen-Zyklen hängen genau an diesen Zustandswechseln. Die Langzeitstatistik kann An/Aus-Dauern nicht abbilden.
🧩 Die Konfiguration: Recorder in eine eigene Datei auslagern
Die Exclude-Liste wurde mit der Zeit lang. Deshalb habe ich den kompletten recorder:-Block aus der configuration.yaml in eine eigene Datei recorder.yaml ausgelagert. In der configuration.yaml steht nur noch eine Zeile:
recorder: !include recorder.yamlDie recorder.yaml liegt im selben Ordner und beginnt in Spalte 0 – sie enthält ja den Inhalt des recorder:-Blocks. Hier die (gekürzte) Struktur:
db_url: !secret recorder_db_url
purge_keep_days: 365
auto_purge: true
exclude:
  domains:
    - device_tracker   # Netzwerk-Präsenzrauschen (~37 Mio. Zeilen)
    - automation       # Logbuch kommt aus events, nicht aus states
    - weather
    - media_player
    - camera
    - update
    - button
    - sun
    # ... weitere Domains ohne Nutzwert für Historie
  entities:
    - sensor.system_uptime
    - sensor.system_rx_received
    - sensor.time
    # ... Diagnose- und Rechenwerte
  entity_globs:
    # SMA-Wechselrichter: Detailwerte raus, Leistung/Ertrag bleiben
    - sensor.sn_*_voltage_l?
    - sensor.sn_*_current_l?
    - sensor.sn_*_pv_voltage_?
    - sensor.sn_*_pv_current_?
- sensor.sn_*_power_l?👉 Vorteile der Auslagerung:- Die
configuration.yamlbleibt übersichtlich - Jede Exclude-Gruppe lässt sich mit Kommentar und Datum dokumentieren – warum ist das drin, was wurde geprüft?
- Änderungen am Recorder sind in einer Datei nachvollziehbar
💡 Entity-Globs (sensor.sn_*_power_l?) sind Gold wert, wenn ein Gerät dutzende ähnlich benannte Sensoren erzeugt. Teste sie aber vorher mit einer Abfrage auf die Datenbank, ob sie wirklich nur das treffen, was du meinst.
🔐 Zum Passwort: Die db_url enthält Zugangsdaten. Besser als Klartext ist !secret – aber Vorsicht: Legst du den Eintrag in der secrets.yaml nicht korrekt an, findet Home Assistant die Datenbank nicht und fällt stillschweigend auf eine leere SQLite-Datenbank zurück. Erst Secret anlegen, dann umstellen, dann prüfen, dass weiter in die MariaDB geschrieben wird.
🪤 Falle 1: Die Einrückung – und warum „Konfiguration gültig“ nicht reicht
Mein erster Versuch mit einem exclude:-Block hat nichts bewirkt. Die Entities bekamen trotz Neustart weiter neue Zeilen. Die Ursache war banal: Auf dem Live-Server stand exclude: auf derselben Einrückungsebene wie recorder: statt darunter. Home Assistant hat es als eigene Integration namens „exclude“ interpretiert:
Integration error: exclude – Integration ‚exclude‘ not found
Der Recorder hat nie eine Exclude-Liste gesehen. Zusätzlich war die lokale Kopie der Datei korrekt, der Live-Server aber nicht – die beiden waren unbemerkt auseinandergelaufen.
Was ich daraus mitgenommen habe:
- ✅ Nach jeder Änderung an der Recorder-Konfiguration Home Assistant vollständig neu starten – ein Reload reicht beim Recorder nicht.
- ✅ Nicht nur „Konfiguration gültig“ abhaken, sondern die Liste der Konfigurationswarnungen durchsehen.
- ✅ Einen Wachstumstest machen: Nach dem Neustart die Zeilen der ausgeschlossenen Entities zählen, ein paar Minuten warten, nochmal zählen. Bleibt der Wert stabil, wirkt das Exclude.
🗑️ Schritt 2: Die Altdaten loswerden
Ein Exclude verhindert nur neue Zeilen. Die Millionen alten bleiben in der Datenbank. Mein erster Ansatz, den Service recorder.purge_entities zu nutzen, hat bei dieser Datenmenge nichts sichtbar bewirkt – auch keine Logeinträge, weil der Logger auf warning stand.
Also habe ich direkt per SQL gelöscht. Das ist der Teil, bei dem es schwierig wurde – und auch der Teil, bei dem ich dir dringend ein Backup vor dem ersten DELETE empfehle.
💥 Problem A: Fremdschlüssel (ERROR 1451)
Die Tabelle states verweist mit old_state_id auf sich selbst. Löscht man eine Zeile, auf die eine andere noch zeigt, bricht die Datenbank mit einem Foreign-Key-Fehler ab.
Lösung: Die Referenzen vor jedem Batch gezielt auf NULL setzen und erst danach löschen.
💥 Problem B: Die Lock-Tabelle läuft über (ERROR 1206)
The total number of locks exceeds the lock table size
Eine einzelne Anweisung hält Row-Locks für alle betroffenen Zeilen gleichzeitig. Die Lock-Tabelle ist aber an den innodb_buffer_pool_size gekoppelt – und der ist auf einem kleinen Container (bei mir 1 GB RAM) begrenzt. Wiederholen hilft nicht. Hier hilft nur kleinere Batches.
💥 Problem C: Die Batches werden immer langsamer
Das war das hartnäckigste Problem. Selbst bei winzigen Batches dauerte ein Durchlauf mehrere Minuten. Erst ein EXPLAIN hat die Ursache gezeigt:
UPDATE states SET old_state_id = NULL
WHERE old_state_id IN (SELECT state_id FROM tmp_delete_targets ...);
MariaDB hat trotz vorhandenem Index die komplette Tabelle (über 200 Mio. Zeilen) gescannt und für jede Zeile die Unterabfrage geprüft – statt umgekehrt von der kleinen Hilfstabelle aus im Index nachzuschlagen. Die Batchgröße war daher fast egal.
Die Lösung war ein einfacher Umbau von Unterabfrage auf JOIN:
UPDATE states s
JOIN (SELECT state_id FROM tmp_delete_targets ORDER BY state_id LIMIT 500000) t
  ON s.old_state_id = t.state_id
SET s.old_state_id = NULL;
Ergebnis: Batches, die vorher Minuten brauchten, liefen in unter einer Sekunde.
💡 Merksatz: Wenn ein Löschjob langsamer statt schneller wird, nicht an der Batchgröße drehen, sondern mit EXPLAIN den Ausführungsplan ansehen.
🧰 Das Arbeitsmuster
Am Ende sah mein Vorgehen bei jeder Löschaktion gleich aus:
1. Zu löschende state_ids einmal in eine Hilfstabelle materialisieren
2. Darin in Blöcken arbeiten: Referenzen auflösen → löschen → Block aus der Hilfstabelle entfernen
3. Den Block so oft wiederholen, bis die Hilfstabelle leer ist
4. Zur Kontrolle neu zählen
Dadurch ist auch ein Abbruch harmlos: Alles, was fertig ist, ist committet, der Fortschritt steht in der Hilfstabelle.
📶 Nebenbei: Die Verbindungsabbrüche
Bei langen Löschläufen bekam ich immer wieder ERROR 2013 / ERROR 2006 („Lost connection“). Mein erster Verdacht war WLAN oder ein NAT-Timeout – bestätigt hat er sich nicht. Auffällig war, dass die Abbrüche mit der Laufzeit eines einzelnen Statements korrelierten (ab etwa 80 Sekunden) und dass ein Neustart des Datenbank-Containers Ruhe brachte. Nach der Bereinigung sind sie bei mir nicht mehr aufgetreten. Ich beobachte es weiter – als Faustregel: lieber viele kurze Statements als ein langes.
💾 Falle 2: OPTIMIZE TABLE meldet „OK“ – und nichts passiert
Gelöschte Zeilen geben in InnoDB den Platz nicht an das Dateisystem zurück. Die .ibd-Datei bleibt gleich groß. Erst OPTIMIZE TABLE baut die Tabelle neu auf und verkleinert die Datei.
Bei mir meldete OPTIMIZE TABLE states; „OK, keine Fehler“ – und die Datei hatte danach unverändert 51 GB.
Der Grund: Der Rebuild legt eine komplette Kopie der Tabelle an. Dafür braucht es kurzzeitig mehr als die Tabellengröße an freiem Platz. Bei mir waren nur ~35–40 GB frei – für eine 51-GB-Tabelle zu wenig. Der Rebuild wurde übersprungen, ohne Fehlermeldung.
Die Lösung: Die Festplatte des Containers vergrößern (bei mir Proxmox: Root-Disk von 125 GB auf 188 GB, geht online). Danach lief der Rebuild durch: states von 51 GB auf 37 GB.
⚠️ Noch eine Falle: Verlass dich nicht auf information_schema.tables (data_length, data_free). Bei InnoDB sind das nur Schätzwerte aus einer kleinen Stichprobe, die nach vielen Deletes stark danebenliegen können. Verlässlich ist nur die echte Dateigröße:
ls -lh /var/lib/mysql/homeassistant/states.ibd
df -h /
Nach den weiteren Exclude-Runden und Löschläufen (64 Mio. Zeilen der SMA-Detailwerte, Einzelsensoren und Energie-Manager-Werte, dazu 17 weitere Domains) schrumpfte states auf 22 GB.
👻 Falle 3: state_attributes – die unsichtbaren Waisen
Nach all dem war states deutlich kleiner – aber state_attributes stand unverändert bei 19 GB und 52 Millionen Zeilen.
Der Grund: Jeder State verweist auf einen Attributsatz. Wenn ich States per SQL lösche, bleiben die zugehörigen Attributsätze verwaist zurück. Eine Stichprobe ergab: 72 % der Zeilen (hochgerechnet rund 37 Millionen) wurden von keinem State mehr gebraucht.
Mein erster Versuch war ein recorder.purge mit repack: true. Ergebnis: nichts. Der Grund: Der Home-Assistant-Purge räumt Attribute nur auf, wenn er gerade selbst States löscht. Für Waisen, die durch meine SQL-Löschung entstanden sind, gibt es keine States mehr, die er anfassen könnte – und ein Repack kopiert die Waisen einfach mit.
Die Lösung in zwei Teilen:
1. Die Waisen per SQL entfernen – in Bereichen von je einer Million IDs, mit einem Anti-Join gegen states:
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;

DELETE FROM state_attributes
WHERE attributes_id >= @start AND attributes_id < @start + 1000000
  AND NOT EXISTS (SELECT 1 FROM states s
                  WHERE s.attributes_id = state_attributes.attributes_id);
Ein paar Hinweise dazu:
- Voraussetzung ist der Index
ix_states_attributes_idaufstates(Standard bei Home Assistant). Ohne ihn wird der Anti-Join unbrauchbar langsam. - Vorab einen Trockenlauf mit
SELECT COUNT(*)auf einem Bereich machen. Bei mir: 2,8 Sekunden für eine Million IDs, 732.000 davon verwaist. READ COMMITTEDverhindert, dass dasDELETESperren aufstates-Indexlücken setzt und den Recorder blockiert. So konnte Home Assistant währenddessen weiterlaufen.- Den Fortschritt habe ich in einer kleinen Tabelle mitgeführt und denselben Block gut 50-mal wiederholt.
- Zum Schluss zählen: 14,5 Millionen Zeilen übrig, null Waisen mehr.
2. Danach den Platz zurückholen – diesmal mit dem Home-Assistant-Service, der nach dem Aufräumen tatsächlich etwas zu verkleinern hat:
action: recorder.purge
data:
  keep_days: 365
  repack: true
Der Repack lässt Home Assistant selbst OPTIMIZE auf den Tabellen laufen. Dabei ist der Recorder blockiert und die Queue wächst an – schau währenddessen ins Log auf Recorder queue-Meldungen. Bei mir dauerte es nicht lange, und das Ergebnis war eindeutig:
state_attributes: 19 GB → 5,1 GB.
⚠️ Das Restrisiko beim Löschen im laufenden Betrieb: Home Assistant hält Attribut-IDs in einem Cache. Löscht du einen Attributsatz, den Home Assistant genau in diesem Moment für einen neuen State wiederverwendet, hat dieser State keine Attribute. Das betrifft nur Sätze, die seit über einem Jahr nicht mehr vorkamen, und ist in der Praxis sehr unwahrscheinlich. Wer es ausschließen will, stoppt Home Assistant für die Dauer der Löschung.
📊 Das Ergebnis
| Vorher | Nachher | |
|---|---|---|
states | ~50 GB | ~22 GB |
state_attributes | ~18–19 GB | ~5 GB |
| Gesamt-Datenbank | ~75 GB | ~35 GB |
Zeilen in states | ~204 Mio. | grob die Hälfte |
| Retention | 365 Tage | 365 Tage |
Ich zeichne jetzt deutlich weniger auf, habe aber nichts verloren, was ich auswerte: Die Verlaufsgraphen im Dashboard, die Grafana-Boards, die Laufzeitstatistiken und die Langzeitstatistiken der wichtigen Sensoren funktionieren unverändert.
✅ Checkliste zum Nachmachen
- 💾 Backup der Datenbank, bevor du direkt per SQL löschst
- 🔍 Analyse: Top-Entities und Domains nach Zeilenanzahl
- 🧪 Prüfung je Entity: Verlaufsgraph? Grafana?
history_stats? Langzeitstatistik? - 🧩 Recorder auslagern:
recorder: !include recorder.yaml, Excludes kommentiert und datiert - 🔁 Vollständiger Neustart, Konfigurationswarnungen prüfen, Wachstumstest
- 🗑️ Altdaten löschen: Hilfstabelle, kleine Batches,
JOINstattIN (Unterabfrage), bei LangsamkeitEXPLAIN - 👻 Attribut-Waisen in
state_attributesnicht vergessen - 💾 Platz zurückholen:
OPTIMIZEoderrecorder.purgemitrepack, vorherdf -hprüfen (mind. die Tabellengröße zusätzlich frei) - 📏 Erfolg an der echten Dateigröße messen, nicht an
information_schema
🧠 Fazit
Eine große Recorder-Datenbank ist kein Schicksal, sondern meist das Ergebnis vieler kleiner „Das schreibt halt mit“-Entscheidungen. Die eigentliche Arbeit ist nicht das Löschen, sondern die Frage, was du wirklich auswertest. Wenn die beantwortet ist, hilft dir die recorder.yaml als saubere, dokumentierte Antwort darauf.
Und noch etwas habe ich gelernt: Bei der Datenbank gibt es drei Stellen, an denen eine Aktion „erfolgreich“ aussieht und trotzdem nichts bewirkt hat – das Exclude mit falscher Einrückung, das OPTIMIZE ohne genug Platz und der Repack über Waisen. Deshalb gilt überall dasselbe: nachmessen.
Wie groß ist deine Recorder-Datenbank, und was war bei dir der größte Speicherfresser? Schreib es gerne in die Kommentare – ich bin gespannt, ob bei dir auch der device_tracker ganz vorne liegt.
📎 Anhang: Die SQL-Abfragen zum Nachmachen
Im Text habe ich nicht jedes Statement gezeigt. Hier findest du die wichtigsten Abfragen gesammelt, bereinigt und in der Reihenfolge, in der ich sie benutzt habe. Sie laufen auf der MariaDB-Datenbank homeassistant. Nimm sie als Vorlage und passe die Entity-Namen an dein System an.
⚠️ Wichtig: Mach vorher ein Backup. Teil 2 und Teil 3 löschen Daten unwiderruflich. Lies bitte zu jedem Schritt die Kommentare, bevor du etwas ausführst.
🔍 Teil 1: Analyse
Diese vier Abfragen zeigen dir, wo das Volumen herkommt und ob eine Entity Langzeitstatistiken hat. Sie ändern nichts an deinen Daten.
-- ============================================================
-- TEIL 1: ANALYSE – wo kommt das Volumen her?
-- Datenbank: homeassistant (MariaDB)
-- ============================================================
USE homeassistant;

-- 1.1 Größe der Tabellen
-- Achtung: Das sind nur Schätzwerte! Die echte Größe steht in der
-- .ibd-Datei (ls -lh /var/lib/mysql/homeassistant/).
SELECT table_name,
       table_rows,
       ROUND((data_length + index_length) / 1024 / 1024) AS size_mb
FROM information_schema.tables
WHERE table_schema = 'homeassistant'
ORDER BY size_mb DESC
LIMIT 10;

-- 1.2 Die 20 Entities mit den meisten Zeilen
SELECT m.entity_id,
       COUNT(*) AS anzahl
FROM states s
JOIN states_meta m ON s.metadata_id = m.metadata_id
GROUP BY s.metadata_id
ORDER BY anzahl DESC
LIMIT 20;

-- 1.3 Zeilen pro Domain (alles vor dem ersten Punkt der entity_id)
SELECT SUBSTRING_INDEX(m.entity_id, '.', 1) AS domain,
       COUNT(*) AS anzahl
FROM states s
JOIN states_meta m ON s.metadata_id = m.metadata_id
GROUP BY domain
ORDER BY anzahl DESC;

-- 1.4 Hat eine Entity Langzeitstatistik?
-- Unbedingt VOR dem Exclude prüfen: Ein Exclude stoppt auch die Statistik.
-- 'sensor.mein_sensor%' durch deine Entity ersetzen.
SELECT sm.statistic_id,
       COUNT(*) AS eintraege,
       MIN(FROM_UNIXTIME(s.start_ts)) AS ab,
       MAX(FROM_UNIXTIME(s.start_ts)) AS bis
FROM statistics s
JOIN statistics_meta sm ON s.metadata_id = sm.id
WHERE sm.statistic_id LIKE 'sensor.mein_sensor%'
GROUP BY sm.statistic_id;🗑️ Teil 2: Altdaten löschen
Das Muster aus dem Text: Zuerst werden die zu löschenden IDs einmal in eine Hilfstabelle geschrieben. Danach arbeitest du sie in kleinen Blöcken ab, bis die Hilfstabelle leer ist. Die Blöcke 2.3 kannst du mehrfach hintereinander in das SQL-Fenster einfügen. Viele kurze Statements liefen bei mir stabiler als ein langes.
-- ============================================================
-- TEIL 2: ALTDATEN LÖSCHEN
-- Voraussetzung: Das Exclude steht in der recorder.yaml und
-- Home Assistant wurde vollständig neu gestartet. Sonst
-- schreibt HA währenddessen neue Zeilen nach.
-- Beispiel hier: die Domain device_tracker.
-- ============================================================

-- 2.1 Vorher zählen
SELECT COUNT(*) AS anzahl
FROM states s
JOIN states_meta m ON s.metadata_id = m.metadata_id
WHERE m.entity_id LIKE 'device_tracker.%';

-- 2.2 Hilfstabelle anlegen und die zu löschenden IDs einmalig eintragen
-- Achtung: Eine TEMPORARY-Tabelle gehört zur Verbindung. Nach einem
-- Verbindungsabbruch diesen Schritt einfach noch einmal ausführen.
DROP TEMPORARY TABLE IF EXISTS tmp_delete_targets;
CREATE TEMPORARY TABLE tmp_delete_targets (state_id BIGINT PRIMARY KEY);

INSERT INTO tmp_delete_targets
SELECT s.state_id
FROM states s
JOIN states_meta m ON s.metadata_id = m.metadata_id
WHERE m.entity_id LIKE 'device_tracker.%'
LIMIT 10000000;

SELECT COUNT(*) FROM tmp_delete_targets;

-- 2.3 Lösch-Block: ALLE VIER Statements zusammen ausführen und so oft
-- wiederholen, bis der Zähler ganz unten 0 zeigt.
-- Bei ERROR 1206 oder sehr langen Laufzeiten: 500000 überall halbieren.

-- a) Verweise auf die Zeilen auflösen (old_state_id zeigt auf den Vorgänger).
--    Wichtig: als JOIN schreiben, nicht als "IN (Unterabfrage)" – das
--    wäre ein Vollscan über die ganze Tabelle.
UPDATE states s
JOIN (SELECT state_id FROM tmp_delete_targets ORDER BY state_id LIMIT 500000) t
  ON s.old_state_id = t.state_id
SET s.old_state_id = NULL;

-- b) Genau diese Zeilen löschen
DELETE s FROM states s
JOIN (SELECT state_id FROM tmp_delete_targets ORDER BY state_id LIMIT 500000) t
  ON s.state_id = t.state_id;

-- c) Den erledigten Block aus der Hilfstabelle entfernen
DELETE FROM tmp_delete_targets ORDER BY state_id LIMIT 500000;

-- d) Fortschritt: noch offene Zeilen
SELECT COUNT(*) FROM tmp_delete_targets;

-- Hatte 2.2 mehr als 10 Mio. Treffer? Dann 2.2 wiederholen (die schon
-- gelöschten Zeilen tauchen nicht mehr auf) und 2.3 erneut durchlaufen.

-- 2.4 Platz zurückholen (erst, wenn alle Löschläufe durch sind)
-- Vorher per "df -h /" prüfen: Es muss mindestens die Tabellengröße
-- zusätzlich frei sein, sonst passiert nichts – auch ohne Fehlermeldung.
OPTIMIZE TABLE states;👻 Teil 3: Verwaiste Attribute entfernen
Das gleiche Prinzip für state_attributes, nur in ID-Bereichen statt mit einer Hilfstabelle voller IDs. Den eigentlichen Platzgewinn bringt danach der recorder.purge mit repack: true aus dem Text.
-- ============================================================
-- TEIL 3: VERWAISTE ATTRIBUTE IN state_attributes ENTFERNEN
-- Nach dem Löschen von states-Zeilen bleiben deren Attribute
-- übrig. Den Platz holt danach recorder.purge mit repack: true.
-- ============================================================

-- 3.1 Index prüfen: ix_states_attributes_id muss in der Liste stehen.
-- Ohne ihn wird der Rest unbrauchbar langsam.
SHOW INDEX FROM states;

-- 3.2 Wertebereich der IDs
SELECT MIN(attributes_id), MAX(attributes_id) FROM state_attributes;

-- 3.3 Trockenlauf: Wie viele Waisen liegen in einem Bereich von 1 Mio. IDs?
-- (Bei mir: 2,8 Sekunden, 73 % verwaist.) Löscht nichts.
SELECT COUNT(*) AS waisen
FROM state_attributes a
WHERE a.attributes_id >= 25000000 AND a.attributes_id < 26000000
  AND NOT EXISTS (SELECT 1 FROM states s WHERE s.attributes_id = a.attributes_id);

-- 3.4 Einmal pro Verbindung: verhindert Sperren auf states, damit
-- Home Assistant währenddessen weiterschreiben kann.
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;

-- 3.5 Fortschrittstabelle (normale Tabelle, übersteht einen Abbruch)
DROP TABLE IF EXISTS tmp_attr_progress;
CREATE TABLE tmp_attr_progress (next_id BIGINT NOT NULL);
INSERT INTO tmp_attr_progress VALUES (0);

-- 3.6 Lösch-Block: alle drei Statements zusammen ausführen und wiederholen,
-- bis next_id größer als der MAX-Wert aus 3.2 ist (bei mir gut 50 Durchläufe).
DELETE FROM state_attributes
WHERE attributes_id >= (SELECT next_id FROM tmp_attr_progress)
  AND attributes_id <  (SELECT next_id FROM tmp_attr_progress) + 1000000
  AND NOT EXISTS (SELECT 1 FROM states s
                  WHERE s.attributes_id = state_attributes.attributes_id);

UPDATE tmp_attr_progress SET next_id = next_id + 1000000;

SELECT next_id FROM tmp_attr_progress;

-- 3.7 Kontrolle (erst ganz am Ende, der zweite Befehl ist langsam):
-- Die Anzahl sollte deutlich gesunken sein, waisen_rest muss 0 sein.
SELECT COUNT(*) FROM state_attributes;

SELECT COUNT(*) AS waisen_rest
FROM state_attributes a
WHERE NOT EXISTS (SELECT 1 FROM states s WHERE s.attributes_id = a.attributes_id);

-- 3.8 Aufräumen – danach in Home Assistant recorder.purge mit repack ausführen
DROP TABLE tmp_attr_progress;Wenn dir dieses DIY-Projekt gefallen hat, schau dir auch meine weiteren Smart-Home- und Home-Assistant-Projekte an. Dort findest du viele weitere Ideen zum Nachbauen.
Vielen Dank für diesen hilfreichen Beitrag. Mein Home Assistant läuft auch schon fast über, da kommen deine Tipps zur Optimierung genau richtig.